香港高防IP的Anycast技术原理:全球清洗节点就近调度如何降低延迟
时间 : 2026-10-16 12:48:35
编辑 : 华纳云
阅读量 : 38
攻击者把流量打向一个IP地址,他以为自己在攻击一台服务器。但流量在骨干网的路由器上被“分流”了——一部分去了香港,一部分去了东京,一部分去了新加坡。攻击者打出的流量被拆成了几份,每一份都被引到了离它最近的清洗节点。这就是Anycast在DDoS防护中最核心的作用:让同一个IP地址在全球多个节点上同时存在,让流量自动走“最近的那条路”。
传统单点防护的死结
要理解Anycast的价值,先看没有它时会发生什么。
传统的DDoS防护模式是“单点清洗”。你的服务器接在一个高防机房里,所有流量——正常的和恶意的——都必须先到达这个机房,清洗后再回源。这个模式有两个硬伤。
第一,清洗能力有上限。 一个机房的清洗带宽是有限的。攻击者打1Tbps的流量过来,机房只有500Gbps的清洗容量,剩下的500Gbps就会把出口堵死。攻击者甚至不需要“打穿”清洗设备,他只需要把带宽打满,正常流量就进不来了。
第二,攻击路径和正常路径重合。 一个美国用户访问香港的服务器,数据包要跨越太平洋。一个欧洲用户访问,数据包要经过中东或大西洋。攻击者如果从欧洲发起攻击,他的恶意流量和欧洲正常用户的流量走的是同一条国际链路。这条链路被攻击流量占满,欧洲的正常用户就访问不了。
Anycast要同时解决这两个问题。
Anycast的核心机制:一个IP,多个“分身”
Anycast的中文叫“任播”,和Unicast(单播)相对。
Unicast是“一个IP对应一个物理位置”。你访问 1.1.1.1,这个IP只在一个地方,所有流量都往那里跑。
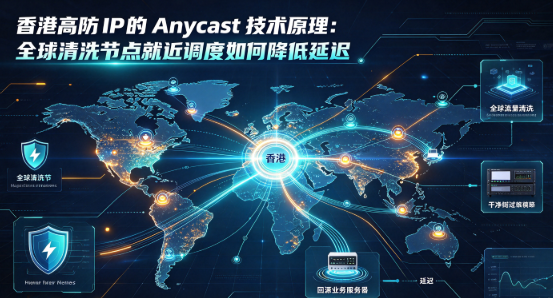
Anycast是“一个IP对应多个物理位置”。同一个IP地址 1.1.1.1,在香港的清洗节点上宣告一次,在东京的清洗节点上宣告一次,在新加坡的清洗节点上也宣告一次。全球的BGP路由器收到三份“通往 1.1.1.1 的路径”通告,每一份来自不同的地理位置。
路由器怎么选? BGP协议选“AS路径最短”的那条。在互联网的拓扑结构里,AS路径最短通常意味着地理上最近、网络跳数最少的那条路。
所以,一个香港的用户访问 1.1.1.1,他的数据包会被香港本地的ISP路由器引导到香港的清洗节点。一个东京的用户访问同一个IP,数据包被引导到东京节点。欧洲的用户被引导到欧洲节点。同一个IP,不同地区的用户连到了不同的物理服务器上。
这个机制对DDoS攻击的意义是根本性的。
就近调度如何降低延迟
Anycast对延迟的改善,来自两个层面。
第一个层面是“物理路径缩短”。
没有Anycast时,一个用户访问你的服务器,数据包必须从用户所在的位置一路跑到你服务器所在的位置。一个东南亚用户访问香港服务器,数据包要跨越南海海底光缆。一个日本用户访问香港服务器,数据包要横穿东海。
有了Anycast,用户的数据包只需要跑到“离他最近的清洗节点”。东南亚用户跑到新加坡节点,日本用户跑到东京节点。清洗完成后的流量,再通过清洗节点之间的专线或骨干网回源到香港。
用户到清洗节点的那一段路径被大幅缩短了。 用户不需要“直达香港”,他只需要“到达就近的清洗节点”。这是Anycast降低延迟的第一层逻辑。
第二个层面是“路径收敛”。
BGP的路由选择不总是完美的。在没有Anycast的情况下,一个用户的数据包可能因为BGP的路由策略问题,走了一条绕路的路径。比如一个广州的电信用户访问香港服务器,数据包可能先绕到北京出口,再折返香港。
Anycast的宣告方式让路由器有更多“就近选择”的机会。广州用户的数据包在广东省内的路由器上,就会看到“去 1.1.1.1 最近的路是去香港节点”,而不是“去北京再出国”。路由决策在更靠近用户的位置就完成了。
有一篇学术研究指出,BGP的路由选择在Anycast场景下经常不是最优的——路由器面对多个“等优先级”的Anycast副本时,可能选了一个距离较远、延迟较高的节点。但这恰恰说明,Anycast的延迟优势不是自动实现的,而是需要精心设计的宣告策略和路由工程。当宣告策略正确时,就近收敛的效果是显著的。
攻击流量如何被“稀释”分散?
Anycast对DDoS防护的价值,不只在延迟,更在攻击流量的分散。
传统单点防护下,1Tbps的攻击流量全部涌向一个清洗中心。清洗中心的入口带宽被打满,清洗设备过载,正常流量无法进入。
Anycast架构下,同一个IP在10个节点宣告,1Tbps的攻击流量被BGP路由分散到10个节点,每个节点承受100Gbps。单点的压力从T级降到了G级。
攻击者面对的是一张“网”,不是一堵“墙”。
更关键的是,攻击流量的来源本身是分散的。一个僵尸网络可能由分布在全球各地的受感染设备组成。这些设备发出的攻击流量,在Anycast架构下会自动被引导到离它们各自最近的清洗节点。欧洲的僵尸设备打的是欧洲的清洗节点,亚洲的僵尸设备打的是亚洲的清洗节点。攻击流量在进入骨干网的那一刻就被“拆分”了。
有一个技术细节值得注意:攻击流量的清洗是在“就近节点”完成的,但清洗后的干净流量需要回源到真正的服务器。这个回源路径通常走清洗节点之间的专线或骨干网络,不经过公共互联网。所以用户感受到的延迟是“用户到就近清洗节点”加上“清洗节点到源站的回源延迟”,而不是“用户直接到源站”的延迟。
如果回源路径足够优化,这个延迟增量可以很小。
香港节点的特殊性
香港高防IP使用Anycast,有一个独特的优势:香港本身就是亚太地区的网络枢纽。
香港拥有丰富的海底光缆登陆站和互联网交换中心。从香港到东南亚主要城市(新加坡、曼谷、吉隆坡、雅加达)的物理距离短,海缆资源充足。从香港到中国大陆南方的延迟在20到50毫秒。从香港到日本、韩国的延迟也在合理范围内。
这意味着,如果一个高防服务商在香港、新加坡、东京都部署了清洗节点,并且使用Anycast宣告同一个IP:
- 中国大陆南方的用户,数据包就近收敛到香港节点
- 东南亚的用户,数据包收敛到新加坡节点
- 日韩的用户,数据包收敛到东京节点
每个用户都走了“到最近清洗节点”的最短路径,而不是全部涌向香港。
有资料提到,香港本地的互联网交换中心对RTBH(远程触发黑洞)和路由社区机制的支持比较成熟,遇到突发攻击时的牵引和分流链路更短、更可控。这意味着攻击发生时,流量重新调度的速度更快。
Anycast的边界:它不解决所有问题
Anycast有一个被广泛讨论的技术限制:TCP会话的稳定性。
如果一个TCP连接建立后,BGP路由发生了变化(比如某个节点故障,流量被重新引导到另一个节点),这个TCP连接会中断。因为新的节点没有这个连接的状态信息。
对于短连接(比如DNS查询、HTTP短请求),这不是问题。对于长连接(比如SSH会话、WebSocket、数据库连接),Anycast可能导致连接在路由变化时被重置。
高防IP的Anycast架构通常需要配合会话保持机制来解决这个问题。一种做法是:Anycast连接只用于“初始引导”,用户通过Anycast IP连接到最近的清洗节点后,清洗节点返回一个重定向(HTTP 302),让用户与真正的源站或后端服务建立Unicast连接。这样Anycast连接本身非常短暂(100到300毫秒),路由变化导致连接中断的概率大大降低。
另一个边界是:Anycast不改变“回源路径”的延迟。用户的流量被就近清洗了,但清洗后的流量如果回源链路很长,用户感受到的总延迟可能并不低。Anycast解决的是“用户到清洗节点”这一段,回源那一端需要单独的优化。
常见问答
问:Anycast和CDN的“就近节点”是一回事吗?
原理相似,但用途不同。CDN的Anycast或DNS调度是为了让用户就近获取缓存内容,优化的是“内容分发”。高防IP的Anycast是为了让攻击流量就近被清洗,优化的是“安全防护”。两者可以叠加使用,但解决的问题不同。
问:香港高防IP的Anycast,中国大陆用户会被引导到哪个节点?
取决于BGP路由的收敛结果。如果香港节点有直连中国大陆的优质路径,大陆用户的数据包大概率会在香港节点收敛。如果香港节点到大陆的路由质量不佳,BGP可能把用户引导到其他节点。这就是为什么Anycast的“就近”不总是等于“最优”——BGP选的是AS路径最短,不是延迟最低。服务商需要通过路由工程(比如调整BGP社区属性、MED值)来引导流量走最优路径。
问:Anycast会导致延迟增加吗?
Anycast本身不增加延迟。数据包还是走单播,只是“目的地”变成了多个副本。路由器的转发决策和普通单播没有区别。Anycast的延迟优势来自“就近收敛”——用户连到更近的节点。但如果BGP选择了错误的节点(比如绕路的节点),Anycast的延迟可能反而比单播更高。
问:攻击者知道IP是Anycast的,能针对性绕过吗?
攻击者可以尝试“打穿”某个单点节点。但如果Anycast网络有足够的节点冗余和负载均衡机制,单点过载时BGP会自动撤销该节点的宣告,流量被引导到其他健康节点。攻击者需要同时打垮所有宣告同一IP的节点,才能让服务彻底中断。这个成本远高于攻击单点架构。
问:香港高防IP用Anycast,是不是就不需要BGP牵引了?
Anycast本身就是一种BGP宣告策略。高防场景下的“流量牵引”通常指的是:检测到攻击后,通过BGP更新把流量从源站引导到清洗中心。Anycast架构下,同一个IP一直在多个清洗节点宣告,流量天然就在清洗节点上,不需要“牵引”这个动作。攻击发生时,流量已经在就近节点被清洗了。
 相关内容